🎓Методы машинного обучения: с учителем, без учителя и с подкреплением
🧑🏫Обучение с учителем (Supervised Learning)
Обучение с учителем является одним из самых популярных методов в машинном обучении. В этом подходе каждому образцу в наборе данных назначается заранее известное ожидаемое выходное значение, также называемое целевой переменной. Например, можно рассмотреть таблицу данных о кредитоспособности, приведённую ниже.
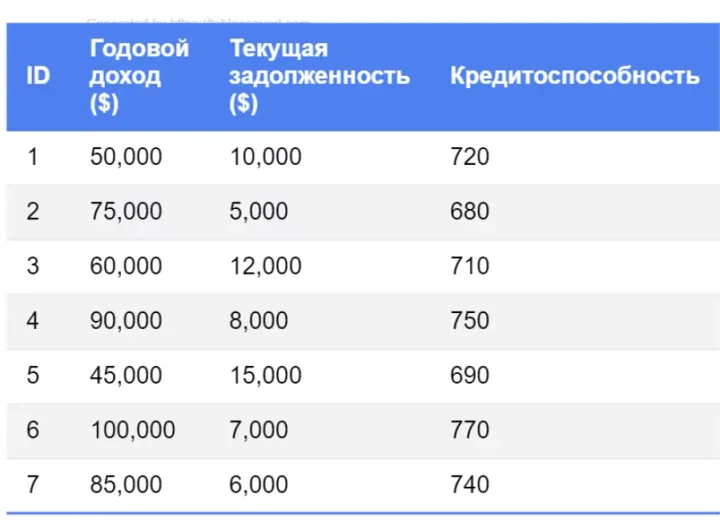
Этот набор данных включает столбцы, которые отражают различные признаки: 'Годовой доход', 'Текущая задолженность', а также целевой признак 'Кредитоспособность'. Целевой признак обозначает характеристику, которую мы пытаемся предсказать, используя остальные признаки.
В обучении с учителем одним из ключевых требований является наличие целевого признака для каждого образца в наборе данных. Однако сбор таких данных может быть весьма сложным и затратным. В некоторых случаях требуется участие экспертов, чтобы корректно определить целевые значения для каждого образца. Тем не менее, наличие этих целевых признаков значительно упрощает процесс обучения модели.
Алгоритм машинного обучения сравнивает предсказанные значения, полученные на основе функции, с фактическими целевыми значениями из набора данных. Это расхождение, или ошибка, используется для корректировки функции и повышения её точности. Таким образом, обратная связь между метками данных и результатами алгоритма играет роль 'учителя' в этом типе обучения.
С математической точки зрения, эта задача обычно сводится к решению задачи оптимизации, где минимизируется определённая метрика (или функция ошибки) с помощью выбранного алгоритма. В данном случае эта функция ошибки указывает, насколько сильно предсказания модели отличаются от фактических данных целевого признака на каждой итерации обучения. Таким образом, мы итеративно стремимся найти минимум функции ошибки.
Именно благодаря этой обратной связи, где целевые значения помогают алгоритму лучше адаптироваться к данным, этот метод называется обучением с учителем. Повторим пример с с кредитоспособностью: целевым признаком является столбец "Кредитоспособность", а остальные признаки, такие как "Годовой доход" и "Текущая задолженность", служат входными данными, на основе которых алгоритм учится предсказывать кредитоспособность.
🔍Обучение без учителя (Unsupervised Learning)
Методы машинного обучения без учителя активно используются для кластеризации данных, когда отсутствует явная целевая переменная, и основная задача заключается в обнаружении скрытых структур в данных. Этот подход особенно полезен, например, при сегментации клиентской базы, когда компании нужно разделить клиентов на определенные группы для создания целевых маркетинговых кампаний или продукции, ориентированной на разные сегменты аудитории.
В отличие от обучения с учителем, методы машинного обучения без учителя работают с данными, которые не имеют заранее определённых целевых значений. Это означает, что алгоритм не может напрямую оценить точность предсказаний, опираясь на известные ответы. Вместо этого, алгоритм стремится выявить группы (или кластеры) схожих объектов, где объекты внутри одного кластера имеют больше общего друг с другом, чем с объектами из других кластеров.
Кластеризация находит применение в различных сферах. В биоинформатике она может использоваться для группировки генов или белков по их функциональной схожести. В маркетинге - для сегментации клиентов в зависимости от их покупательских предпочтений. В анализе текстов алгоритмы кластеризации могут объединять документы по тематике, например, группируя новостные статьи по схожим темам.
Процесс кластеризации обычно начинается с предварительного разделения данных на группы, где алгоритм либо случайным образом распределяет объекты, либо следует указаниям исследователя о предполагаемом числе кластеров. Однако эти начальные кластеры могут не отражать истинные структуры данных, поэтому алгоритм постепенно улучшает кластеризацию, перемещая объекты между кластерами и оптимизируя их соответствие внутри групп. Определение оптимального числа кластеров часто происходит автоматически.
Для оценки качества кластеризации используется функция, направленная на максимизацию сходства внутри кластеров и различий между ними. Один из таких методов связан с вычислением суммы квадратов отклонений (SSE) внутри кластеров, при котором минимизируется разброс объектов внутри каждой группы.
Алгоритм не получает явных целевых значений или меток для каждого объекта. Вместо этого он самостоятельно ищет скрытые закономерности и структуры в данных, определяя, какие объекты следует объединить в кластеры на основе их схожести. В результате работы таких алгоритмов появляются новые метки, например, метки кластеров, которые добавляются в набор данных как новый столбец.
🚗Обучение с подкреплением (Reinforcement Learning)
Обучение с подкреплением (Reinforcement Learning) - это метод машинного обучения, который особенно хорошо подходит для задач, требующих принятия решений в реальном времени, таких как управление роботами или участие в играх. В таких сценариях агент (машинная модель) должен разработать набор правил, которые будут определять его поведение в окружающей среде, стремясь максимизировать получаемое вознаграждение или "подкрепление". Агенту необходимо сопоставлять текущие наблюдения о среде и свое внутреннее состояние с действиями, которые он должен выполнить. Например, робот должен решить, двигаться ли ему вперед или назад, а программа — определить, следует ли переместить пешку или атаковать ферзя в шахматной партии. В результате применения этих правил агент принимает решение о следующем шаге, основываясь на текущей ситуации.
В отличие от других методов машинного обучения, которые используют заранее подготовленные наборы данных, обучение с подкреплением часто происходит в реальном времени. Агент помещается в среду, где начинает с произвольных правил, которые постепенно корректируются в зависимости от получаемого подкрепления. Если агент получает положительное подкрепление, связь между его действиями и наблюдениями усиливается; если подкрепление отрицательное, эта связь ослабевает. Этот процесс является непрерывным циклом формирования и корректировки правил, позволяющим агенту улучшать свою стратегию на основе обратной связи из окружающей среды.
Ключевая особенность обучения с подкреплением заключается в том, что целевая функция (действия агента) отделена от механизма подкрепления. Подкрепление может зависеть от последовательности действий, и поэтому обратная связь не всегда приходит сразу после выполнения действия. Например, представьте, что агент обучается находить кратчайший маршрут на карте города. Вознаграждение +1 он получает за успешное достижение конечной точки по оптимальному пути, и -1, если выбирает более длинный или обходной маршрут. Однако это подкрепление становится доступным только после завершения всей поездки, когда агент достигает цели. Поэтому одной из главных задач обучения с подкреплением является разработка методов, которые позволяют корректно распределять подкрепление по цепочке действий, улучшая правила на основе накопленного опыта.
Значительным прорывом в области обучения с подкреплением стала работа компании DeepMind. Ей удалось продемонстрировать, как этот метод можно применить в глубоких нейронных сетях для разработки стратегий управления в классических видеоиграх для Atari, таких как Breakout, Pong, Space Invaders, Seaquest, Beam Rider, Enduro и Q*bert. Входные данные представляли собой пиксели с экрана, а выходные - действия, которые агент должен выполнять, нажимая кнопки джойстика. Игры обеспечивают идеальную среду для обучения с подкреплением, поскольку позволяют агенту многократно повторять действия без необходимости создания и разметки больших наборов данных.
Сегодня обучение с подкреплением применяется в различных современных задачах. Например, AlphaGo от DeepMind, созданная для игры в го, использует этот метод для обучения через многократные игры против самой себя. Другие примеры включают автономное вождение, где автомобили обучаются оптимальным маршрутам и маневрам в сложных дорожных условиях, и робототехнику, где роботы учатся выполнять сложные задачи, такие как сборка деталей или управление дронами.
Итого коротко: обучение с подкреплением получило такое название благодаря тому, что агент учится на основе подкрепления - положительных или отрицательных сигналов из окружающей среды, которые указывают, насколько успешными были его действия. Эти сигналы служат критерием для обновления правил и стратегий, позволяя агенту со временем улучшать своё поведение и достигать лучших результатов в поставленных задачах.
Комментарии
Войдите, чтобы комментировать.
Комментариев пока нет.